Commencer
Still unsure of the impact of Sonik?
Voyez par vous-même et demandez votre essai gratuit

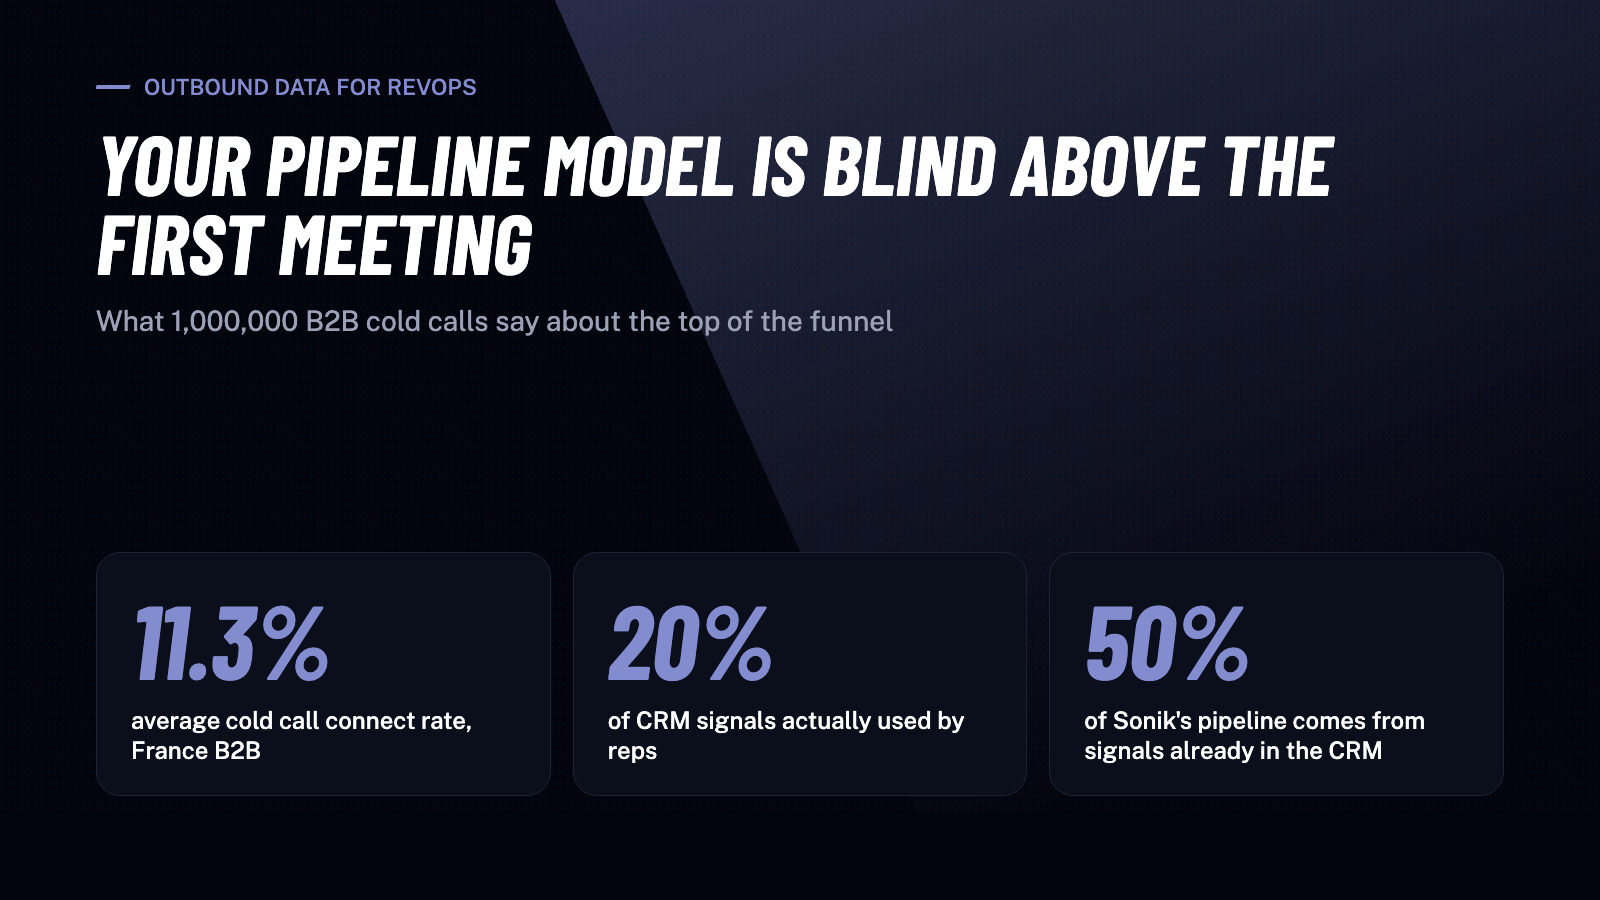
La plupart des stacks de revenue intelligence commencent à enregistrer la vérité au premier rendez-vous. Tout ce qui le précède, les appels passés, les décrochés, l'objection qui a mis fin à l'appel, le signal qui l'a déclenché, vit dans un journal de dialer que personne ne relie au CRM. C'est pourquoi les prévisions construites sur ces stacks paraissent précises et ne le sont pas. La solution n'est pas une couche d'analytique de plus. C'est de consigner les huit bons champs au moment de l'appel, automatiquement.
Les outils de revenue intelligence ont été conçus pour les appels de fin de cycle : découverte, démo, négociation. Ils sont bons pour cela. Mais un modèle de pipeline qui ne voit que les opportunités modélise la sortie d'un process qu'il ne peut pas observer.
Posez trois questions à votre responsable RevOps. Quel était le taux de décroché le mois dernier par persona ? Quel signal a produit le plus de rendez-vous par conversation ? Combien de points de contact a-t-il fallu pour joindre les contacts qui ont pris rendez-vous ? Si la réponse est « le dialer a un rapport pour ça », la donnée n'est pas dans le modèle.
Dans notre benchmark d'un million d'appels à froid B2B en France, le taux de décroché moyen est de 11,3 %, et il varie de 11 % à 20 % selon la persona et le créneau. Une prévision qui suppose une conversion uniforme de « contacts ajoutés » à « rendez-vous pris » se trompe de presque un facteur 2 avant même qu'un AE touche quoi que ce soit.
Voici le schéma minimal. Si un champ est saisi par un commercial après l'appel, partez du principe qu'il manque une fois sur trois.
Une équipe SDR européenne typique fait tourner un fournisseur de données, un outil de séquences, un dialer, un outil de prise de notes et un CRM. Chacun a son propre journal. Les commerciaux ressaisissent ce qui compte, c'est-à-dire ce qui est rapide : « NI » dans un champ de notes.
La dégradation se cumule. Les commerciaux n'utilisent qu'environ 20 % des signaux déjà présents dans leur CRM, en partie parce que le CRM est l'endroit où les données vont pour être oubliées. Pourtant, 50 % du pipeline de Sonik vient de signaux qui étaient déjà dans le CRM avant que quiconque regarde. La donnée est là. Elle n'est simplement pas reliée à l'appel qui aurait dû l'utiliser.
Acheter plus de dashboards par-dessus ne sert à rien. Un dashboard n'est honnête que si la réécriture dans le CRM l'est. Réglez d'abord la réécriture, à la source, et laissez le dialer écrire.
Une fois les huit champs dans le CRM pour chaque appel, trois choses deviennent possibles.
La conversion par segment, pas par moyenne. Au lieu d'un seul taux de décroché, vous obtenez le taux de décroché par persona et par créneau, le taux de rendez-vous par signal, et le nombre de tentatives pour joindre par source de liste. Les personas ventes et direction décrochent au-dessus de 15 % dans nos données ; un 11 % agrégé le masque.
Une planification de capacité avec de vraies entrées. Si votre étoile polaire est de 20 conversations par SDR et par jour, vous pouvez désormais calculer les appels nécessaires par créneau, et si le parallel dialing (qui donne aux commerciaux environ 5 fois plus de conversations par heure) comble l'écart ou s'il vous faut une meilleure liste.
Le ROI des signaux. Quels déclencheurs produisent des rendez-vous par conversation au-dessus de la moyenne de l'équipe ? Dans notre benchmark, appeler un contact connu avec « Comment allez-vous depuis le temps ? » réussit environ 10 % du temps, contre 1,5 % pour une ouverture à froid classique. Les leads dormants sont un signal au rendement mesurable, si vous consignez le déclencheur.
Chacun n'a besoin que des huit champs ci-dessus. Aucun ne demande un nouvel outil si le dialer réécrit correctement dans le CRM.
Le dialer de Sonik écrit chacun des huit champs dans le CRM en fin d'appel : créneau, résultat, tentative, statut final, résumé IA et prochaine étape, plus le signal qui a mis le contact dans la session au départ. Les commerciaux ne saisissent pas les statuts ; ils les confirment.
Comme le signal et le résultat sont stockés ensemble, la RevOps peut répondre à « quels déclencheurs produisent du pipeline » avec un rapport CRM plutôt qu'un export. C'est ainsi que nous savons que la moitié de notre propre pipeline vient de signaux résidant dans le CRM.
Ce que nous ne faisons pas : construire une couche d'analytique séparée. Le CRM reste le système de référence, et votre outil de revenue intelligence existant reçoit de meilleures données en entrée plutôt qu'un concurrent.
La revenue intelligence sans données outbound est un modèle de la seconde moitié d'un process. Avant d'acheter quoi que ce soit, faites un audit cette semaine : exportez les appels du mois dernier depuis votre dialer et comptez combien ont un signal déclencheur, un numéro de tentative et une prochaine étape datée dans le CRM. Si c'est moins de la moitié, le modèle devine, et la solution la moins chère est la réécriture automatique au moment de l'appel.